воскресенье, 18 октября 2020 г.

Apache Ignite cache: Запускаем сервис в Apache Ignite Service Grid. Часть 2

 Начнём с небольшой теории для тех, у кого не было времени ознакомиться с документацией Apache Ignite:

- нода - это один запущенный инстанс Apache Ignite. Документация рекомендует запускать одну ноду Ignite на одной JVM. Что, в грубом приближении, означает, что на одном сервере должна быть запущена только одна нода Apache Ignite. При этом в самой документации сказано, что есть способ запустить несколько нод Ignite на одной JVM, но использовать этот трюк для продакшена не рекомендуется, т.к. теряются все плюсы распределённого кеша : упал сервер - пропали сразу все запущенные на нём ноды со всеми своими кусочками кеша и его резервными копиями;

- кластер - это набор нод, объединённых в одну сеть, выполняющих общую задачу и взаимодействующих друг с другом по общим для них правилам: распределяющих между собой нагрузку, резервные копии кеша, выбирающих друг из друга ноду-координатора (в этом случае остальные ноды будут ведомыми) и т.д.

Ранее я уже писал о том, что в структуре бинарной сборки Apache Ignite есть директория libs, которая содержит библиотеки классов, которые Ignite загружает на старте. Эта директория отмечена цифрой "3" на скриншоте.


Соответственно, для того, чтобы наш сервис был загружен Игнайтом при старте кластера, нам нужно поместить в директорию libs скомпилированные классы нашего сервиса и всех его зависимостей, перечисленных в файле pom.xml. 

Эту операцию нужно будет проделать на всех нодах кластера Игнайт, на которых мы захотим запустить наш сервис. Делать это нужно до того, как была запущена хотя бы одна нода кластера, на которой должен быть запущен наш сервис.

Если хотя бы на одной из таких нод в директории libs не будет классов нашего сервиса той же версии, что на остальных нодах, кластер Игнайта не стартует и выдаст нам ошибку, говорящую о том, что ноды находятся в несогласованном состоянии.

Поместить наш сервис с его зависимостями в директорию libs мы можем двумя способами:

1) Способ, рекомендованный документацией Apache Ignite.

Документация рекомендует скопировать в эту директорию поотдельности: классы сервиса и классы всех его зависимостей. Причина такой рекомендации только одна - при обновлении кода сервиса, в директории libs нужно будет обновить только классы самого сервиса, не трогая классы его зависимостей.

2) Простой способ, который выбрал я.

Собирать наш сервис в "толстый" jar-файл - файл, содержащий все необходимые ему зависимости. И, при необходимости, обновлять наш сервис целиком со всеми зависимостями.

Собрать наш сервис в "толстый" jar-файл можно несколькими способами. Я выбрал maven-shade-plugin, т.к. мне он показался проще и понятнее остальных:


В строках 102 - 104 я исключил из сборки файлы с подписями пакетов зависимостей, т.к. в некоторых специфичных случаях, когда не было возможности проверить подписи пакетов зависимостей, сборка сервиса падала с ошибкой. Возможно в те моменты выход в интернет у меня был через ограниченный прокси-сервис. Если у вас с этим проблем не будет, то подписи лучше оставить как, хоть и небольшую, но гарантию того, что пакеты используемых вами зависимостей не были никем подменены.

суббота, 17 октября 2020 г.

Apache Ignite: Запускаем сервис в Apache Ignite Service Grid. Часть 1

В первой части хочу рассказать о том, как у меня не получалось запустить наш сервис в Service Grid. Во второй - о том, как всё получилось.

Первая попытка запуска закончилась следующим исключением:

Как видно, причина исключения в том, что объект Gson не является сериализуемым. Речь идёт вот об этом поле объекта StartService (строка 27): 

Документация Apache Ignite говорит о том, что в этом случае поле должно быть помечено ключевым словом transient.

Ок. Помечаем поле ключевым словом transient и при следующем запуске получаем новое исключение:

Всеми любимый NullPointerException. Выбрасывается в объекте FileParser при попытке сохранить десериализованный объект в кеш:

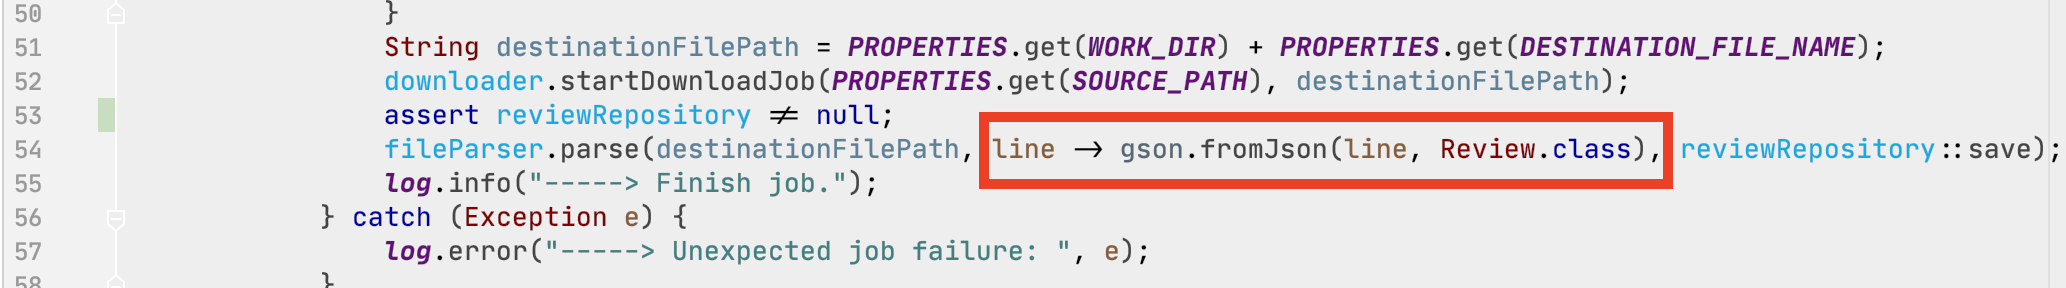
Обкладываемся логгерами и видим, что в 36 строке у нас не происходит десериализации объекта Review из прочитанной из файла строки.

А функция десериализации объекта у нас - это:

Опять Gson! ))

Ситуация исправилась заменой поля Gson gson на локальную переменную метода StartService#execute():

Итог получился таким:

Задача стартовала, файл был загружен и распарсен.

Во второй части статьи я расскажу о том, какие настройки были сделаны мной в файле ignite-config.xml для того, чтобы наш сервис был инициализирован и запустил свою задачу при запуске кластера Apache Ignite.

суббота, 10 октября 2020 г.

Apache Ignite cache: объединяем все компоненты


Для объединения компонентов в одно приложение, нам понадобится проделать большую предварительную работу и как следует отрефакорить наше приложение, т.к. до сих пор оно запускалось у нас только отдельными компонентами в юнит-тестах.

1) Сделаем класс ActivityRepository, реализующий интерфейс CacheRepository, который будет сохранять информацию об активности приложения. Ранее, такой класс мы создавали только в качестве заглушки в тестовых целях. Сейчас делаем его способным работать с кешем Apache Ignite:

В конструктор ActivityRepository мы будем передавать инстанс класса, реализующего интерфейс Ignite, используя метод которого (getOrCreateCache()), мы будем создавать новый или получать уже созданный объект, реализующий интерфейс IgniteCache.


2) Создадим класс ReviewRepository, который будет отвечать за сохранение в кеш и получение из кеша данных, распаренных из нашего датасета:

ReviewRepository будет дополнительно реализовывать интерфейс org.apache.ignite.services.Service, что позволит нам запускать наш сервис в окружении Apache Ignite Service Grid - что-то вроде контейнера для теплая и запуска приложений. Подробнее об этом можно почитать в документации на сайте Apache Ignite.
Для чего нам нужно запускать ReviewRepository в Apache Ignite Service Grid? Это позволит нам в дальнейшем подключаться к ReviewRepository из любого внешнего приложения через специальный прокси, предоставляемый Ignite. Как это делается, мы рассмотрим далее. Для нетерпеливых - есть официальная документация.

3) И, наконец, реализуем наш главный, объединяющий всех, компонент - StartService:

Он, также как ReviewRepository, реализует интерфейс org.apache.ignite.services.Service, но, в отличие от ReviewRepository, полноценно реализует все его методы:

- init() - этот методе вызывается контейнером Service Grid  на стадии инициализации нашего сервиса. Пока здесь оставим заглушку, но в дальнейшем, используем и этот метод;

- execute() - этот метод вызывается после того, как сервис будет полностью инициализирован. Именно здесь мы разместим основную логику нашего сервиса.

Как видно из листинга кода, сначала мы стандартным способом, через оператор new, создаём инстансы  ActivityRepository, FileManager Downloader, FileParser. Затем создаём инстанс ReviewRepository через прокси, предоставляемый Apache Ignite для объектов, реализующих интерфейс org.apache.ignite.services.Service.

На своём старте, Apache Ignite проверяет наличие в специально отведённой директории классов для загрузки, загружает их, создаёт инстансы классов, реализующих интерфейс Service,  и вызывает их методы init, execute, cancel.

Т.к. инстанс ReviewRepository уже был создан Apache Ignite, нам нет необходимости создавать его снова. Вместо этого, мы можем использовать предоставленный нам прокси для вызова методов ReviewRepository.

После инициализации компонентов, мы создаём объект worker, реализующий интерфейс Runnable, который будет по расписанию выполнять всю полезную работу. 

Для начала, worker создаёт рабочие директории. Если не может создать, то завершает работу. Если рабочие директории были созданы успешно, worker даёт другим компонентам команды загрузить файл, распарсить его и сохранить в кеш.

Первый раз мы запускаем worker на выполнение сразу после создания. Затем, создаём scheduledExecutor и задаём ему расписание запуска worker’а.

- cancel() - этот метод вызывается при остановке нашего сервиса. Для остановки сервиса необходимо либо передать в Service Grid специальную команду, либо остановить кластер Apache Ignite.

4) Пишем утилитный класс для работы с датой и временем:

5) Ну, и не забываем писать юнит-тесты.


Пока оставим всё как есть и поверим юнит-тестам. В следующий раз запустим всё это добро вместе с Apache Ignite и посмотрим, не ошиблись ли мы в чём-нибудь.


воскресенье, 4 октября 2020 г.

Apache Ignite cache: разворачиваем Apache Ignite локально

Теперь, нетерпеливые мальчики и девочки, настало время самого интересного: разворачиваем Apache Ignite на своём локальном ПК. Это нам нужно для того, чтобы двигаться дальше в деле создания нашего приложения.

Описанные далее инструкции будут работать для Linux и MacOS. Желающие запустить Ignite на Windows могут посмотреть в официальной документации, как это правильно сделать.

Начать, конечно же, стоит с ознакомления с документацией Apache Ignite. Именно там описаны все возможные способы поднятия Ignite. 
По неизвестной мне причине, авторы документации “топят” за конфигурирование Ignite в java коде - именно в этом ключе дано большинство примеров в документации.

Но мы-то с вами уже ранее договорились, что вся конфигурация у нас должна быть во внешнем файле, чтобы дать возможность инженерам DevOps с ней работать без необходимости лезть в код нашего хоть и скоромного, но от того не менее непонятного для людей, далёких от java, приложения.

Начинаем с загрузки и распаковки бинарного пакета.

Что интересного в этом пакете:
1 - скрипт для запуска Ignite
2 - директория с конфигами (Ignite, логгера)
3 - директория с библиотеками классов, которые подтягивает Ignite на старте
4 - рабочая директория Ignite, куда он складывает созданные в ходе работы файлы (например, логи).

Запускаем Ignite в консоли командой:
./ignite.sh
 
Если хотим видеть в консоли подробные логи Ignite, то  добавляем флаг ‘-v’. В результате кластер запустится verbose-режиме и весь лог можно будет видеть в консоли:
./ignite.sh -v


Если хотим запустить кластер с нашей конфигурацией, которую мы в скором времени напишем, то запускаем кластер командой:
./ignite.sh -v /path/to/our/ignite-config.xml

Для начала, в качестве нашего первого конфига, возьмём из директории пакета копию файла конфигурации: ./config/default-config.xml и переименуем её в ignite-config.xml.
Тогда, если в терминале мы будем находиться в корневой директории пакета Apache Ignite, команда запуска у нас будет такой:
./bin/ignite.sh -v /config/ignite-config.xml

Для удобства я положу этот файл в репозиторий проекта в директорию configs.


Apache Ignite cache: пишем компонент, управляющий директориями на диске

Вначале я планировал написать класс, который будет предоставлять методы для работы с загруженными файлами: посмотреть список загруженных, удалить старые и т.д.

Но потом вспомнил, что у нас ровно один файл, чьё название никогда не изменяется, и решил сделать компонент, который будет отвечать только за создание рабочей директории для приложения.

Рабочая директория нужна приложению для загрузки в неё файла с датасетом. Если такая директория отсутствует и её невозможно создать, то смысла в работе остальных компонентов приложения (загрузчик фалов и парсер) не будет. 

Получился вот такой класс FileManager:

@Slf4j
public class FileManager {

    /**
     * Create directory if not exists.
     *
     * @param path {@link String} path to the directory.
     * @return {@code true} if directory was created successful or directory already exists, {@code false} if got
     * Exception.
     */
    public boolean createIfNotExists(String path) {
        try {
            File dir = new File(path);
            if (!dir.exists()) {
                log.info("Create directory {}.", dir);
                return dir.mkdirs();
            } else {
                log.info("Directory {} already exists.", dir.getPath());
                return true;
            }
        } catch (Exception e) {
            log.error("Exception when try check or create directory: {}", path);
            return false;
        }
    }
}

Юнит-тест подтверждает, что этот класс работает так, как нам нужно:

public class FileManagerTest {

    private final String path = Objects.requireNonNull(getClass().getClassLoader().getResource(".")).getPath()
        + "test-work-dir";

    @Test
    public void createIfNotExists_shouldCreateDirectoriesInWorkDirectory() {
        FileManager fileManager = new FileManager();
        boolean result = fileManager.createIfNotExists(path);

        assertTrue(result);

        File dir = Paths.get(path).toFile();

        assertTrue(dir.exists());
        assertTrue(dir.isDirectory());

        assertTrue(dir.delete());
    }

    @Test
    public void createIfNotExists_shouldCorrectWorkIfWorkDirectoryAlreadyExists() {
        FileManager fileManager = new FileManager();
        boolean result1 = fileManager.createIfNotExists(path);
        boolean result2 = fileManager.createIfNotExists(path);

        assertTrue(result1);
        assertTrue(result2);

        File dir = Paths.get(path).toFile();

        assertTrue(dir.exists());
        assertTrue(dir.isDirectory());

        assertTrue(dir.delete());
    }
}

суббота, 3 октября 2020 г.

Apache Ignite cache: пишем компонент регистрации активности приложения

Наше приложение будет по расписанию запускаться, например, каждый час, скачивать нужный нам файл и проверять: если файл изменился, то необходимо распарсить его заново. Если не изменился, то ничего с ним делать не нужно.

Компонент регистрации активности приложения как раз и будет сохранять в кеш Apache Ignite информацию о том, какие файлы уже были обработаны нашим приложением.

Ключом для кеша будет имя файла (включая путь к файлу), а значением - модель Activity с полями: путь к файлу и хэш-сумма файла.

@Data
@AllArgsConstructor
public class Activity {
    private String path;
    private String checkSum;
}

Хэш-сумма файла будет вычисляться в приватном методе парсера файлов.
    private String getChecksum(String path) {
        try {
            MessageDigest md = MessageDigest.getInstance("SHA-256");
            md.update(Files.readAllBytes(Paths.get(path)));
            byte[] digest = md.digest();
            return DatatypeConverter.printHexBinary(digest).toUpperCase();
        } catch (Exception e) {
            log.error("Error get checksum for the file '{}'", path, e);
        }
        return null;
    }

Обновим тест парсера файлов, чтобы проверить, что один и тот же файл парсится только один раз.
    @Test
    public void parseFile_shouldParseTheSameFileOnlyOnce() {
        parser.parse(path, line -> gson.fromJson(line, Review.class), reviewRepository::save);
        parser.parse(path, line -> gson.fromJson(line, Review.class), reviewRepository::save);

        verify(reviewRepository, times(26)).save(any(Review.class));
        verify(activityRepository, times(2)).findById(path);
        verify(activityRepository, times(1)).save(any(Activity.class));

        assertEquals(26, reviewRepository.count());
        assertEquals(1, activityRepository.count());
    }

 Apache Ignite cache: работаем с GitHub репозиторием

Решил рассказать, как работаю с репозиторием GitHub на этом проекте.
Есть много вариантов работы с системой контроля версий:
- Git flow,
- GitHub flow,
- GitLab flow,
- другие.
Они все сложные, многоуровневые и хорошо подходят для распределённой работы в большой команде.
Т.к. я работаю над проектом один и у проекта нет CI/CD pipeline, то я выбрал для себя упрощённый вариант работы с git-ом:
1. До начала работы разбиваю проект на подзадачи и пишу их в виде Issue:

1 - вкладка с задачами
2 - кнопка для создания новой задачи
3 - название созданной задачи
4 - каждой задаче автоматически присваивается номер

2. Для работы над задачей создаю новую ветку от основной ветки.
3. После завершения работы над задачей и пуша изменений в репозиторий, создаю пулл-реквест:

В названии пулл-реквеста можно указать номер задачи, которую хотим закрыть этим пулл-реквестом. Если этого не сделать, задача останется открытой и её можно будет закрыть позже вручную:


 При создании задачи, пулл-реквеста и закрытии задачи, нужно писать подробные комментарии для других разработчиков и себя самого, чтобы снизить вероятность принятия неправильного решения при выполнении задачи, принятии или отклонении пулл-реквеста и закрытии задачи.


Что касается пулл-реквеста, правила хорошего тона в разработке говорят, что при его создании необходимо:
- чтобы объём кода в пулл-реквесте был небольшим и позволял провести код-ревью в течение не более 10 - 20 минут;
- убедиться, что все внесённые в код изменения покрыты тестами и все тесты проходят успешно;
- убедиться, что код проходит проверки Checkstyle, SonarQube и др. линтеров;
- написать комментарий к пулл-реквесту, в котором рассказать, какую задачу он решает, что именно сделано в коде и почему (если принятые решения не очевидны).

Соблюдайте эти простые правила и ревьюеры будут выстраиваться в очередь, чтобы поревьюить ваш код.
Почему? Да потому, что он не будет вызывать у них приступов раздражения, головной боли или отнимать половину рабочего дня на то, чтобы разобраться, что ваш код делает и, на что оказывает влияние в проекте.

пятница, 2 октября 2020 г.

Apache Ignite cache: Создаём интерфейсы репозитория

 Решил сделать два интерфейса репозитория:

- с доступом на чтение;

- с полным доступом.

Доступ на чтение будем предоставлять пользователям кеша. Какой в этом смысл? Смысл такой, что наши пользователи не смогут писать в кеш. Смогут только читать из него. Такова идея этого проекта. Если в каком-то другом проекте понадобится доступ пользователям на запись в кеш, тогда разделять репозиторий на два интерфейса будет не нужно.

Вот такие два интерфейса получились:

public interface ReadCacheRepository<K, V> {

    Optional<V> findById(K id);

    boolean existsById(K id);

    long count();
}

public interface CacheRepository<K, V> extends ReadCacheRepository<K, V> {

    void save(V value);

    void deleteById(K key);
}

Как я уже писал ранее, кеш Apache Ignite имеет интерфейс почти такой же, как у HashMap.

Apache Ignite cache: Пишем парсер файлов

 Не успел я написать утилиту для работы с архивными файлами, как пришла пора отправить её на заслуженный отдых.


Когда писал парсер JSON-файла, вспомнил, что есть библиотека java.uti.zip и когда-то давно я с её помощью читал заархивированные в zip-формате файлы, без предварительного их разархивирования. Посмотрел в документацию и нашёл, что ровно то же самое можно делать и с gzip-файлами.


Отлично. Одним рефакторингом мы избавляемся:
- от утилиты,
- от необходимости придумывать, из какого класса её вызывать,
- от необходимости её тестировать и сопровождать,
- от распакованных файлов, которые будут занимать лишнее место на диске.

Теперь наш парсер будет читать файлы из архивов:

    public <T> void parse(String path, Function<? super String, T> create, Consumer<T> save) {
        log.info("Start parsing file: {}", path);
        try (FileInputStream fis = new FileInputStream(path);
             GZIPInputStream gzis = new GZIPInputStream(fis);
             InputStreamReader isr = new InputStreamReader(gzis, StandardCharsets.UTF_8);
             BufferedReader br = new BufferedReader(isr)) {
            br.lines()
                .parallel()
                .map(create)
                .forEach(save);
            log.info("Finish parsing file: {}", path);
        } catch (Exception e) {
            log.error("Error parsing file: {}", path, e);
        }
    }

На вход метод получает путь к файлу и две функции: функцию, которая будет преобразовывать строки из JSON-файла в нашу модель Review и функцию, которая будет сохранять распарсенные данные в кеш.

Как это работает, можно посмотреть в тесте:

    @Test
    public void parseFile() {
        Gson gson = new Gson();
        CacheRepository<String, Review> reviewRepository = new ReviewTestRepository();
        String path = Objects.requireNonNull(
                getClass().getClassLoader().getResource("reviews_Electronics_5_short.json.gz")
        ).getPath();
        FileParser parser = new FileParser();
        parser.parse(path, line -> gson.fromJson(line, Review.class), reviewRepository::save);

        assertEquals(26, reviewRepository.count());
    }

Apache Ignite cache: Пишем утилиту для работы с архивными файлами

 Так как датасет мы скачиваем заархивированным в формат gzip, для дальнейшей работы с ним нам необходимо будет разархивировать его.

Для этого я решил написать утилитный класс:

public static void decompressGzip(File input, File output) throws IOException {
        try (GZIPInputStream in = new GZIPInputStream(new FileInputStream(input))){
            try (FileOutputStream out = new FileOutputStream(output)){
                byte[] buffer = new byte[1024];
                int len;
                while((len = in.read(buffer)) != -1){
                    out.write(buffer, 0, len);
                }
            } catch (Exception e) {
                log.error("Error decompress file. Input: {} Output: {}",
                        input.getAbsolutePath(), output.getAbsolutePath(), e);
            }
        }
    }

Работает утилита шустро и свою задачу выполняет. Тест это подтверждает:

@Test
    public void testDecompressGzip() throws IOException {
        File input = new File(resources + "reviews_Electronics_5_short.json1.gz");
        File output = new File(resources + "reviews_Electronics_5_short1.json");

        GzipUtility.decompressGzip(input, output);
        Path path = Paths.get(resources + "reviews_Electronics_5_short1.json");

        assertTrue(Files.exists(path));
    }

Скорее всего, я помещу вызов этой утилиты в класс Downloader.